诊断报告 · Trae IDE × Vibe API
Trae IDE 接入 Vibe API 异常的根因,不在中转侧, 而在四层接入方式。
某大客户在 Trae IDE 的 Solo 模式下,通过 SSH 连接远程服务器开发大型项目,反馈 模型表现异常、频繁掉线、消耗偏高。 经远程排查,问题根源并不在 Vibe API 中转侧 —— 而是 Trae 的接入方式,在接口、链路、调度、配置四个层面共同造成。
问题概述与主要现象
客户当前的使用方式为:在 Trae IDE 的 Solo 模式下,通过 SSH 连接远程服务器进行开发,项目体量较大。 下面四类现象,与同一模型在其它客户端下的表现并不一致。
经远程协助排查,问题根源并不在 Vibe API 中转侧,
而是由 Trae 的接入方式 —— 在接口、链路、调度、配置四个层面的特性共同造成。
问题归纳:四层速览
四个层面的问题与对应措施汇总如下。点击每一层展开处理措施,逐层的详细分析与证据见下一节。
处理措施
改用官方插件,走原生 Responses 接口。该问题位于接入链路根部,中转侧无法修复,需 Trae 官方升级;短期内建议直接规避。
处理措施
改用插件直连,规避「本地 → 字节美国服务器 → 中转」的额外跨境环节,稳定性可明显改善。
处理措施
项目读取 / 扫描等轻任务用 Haiku,复杂任务再用 Opus,避免全程高价模型,可显著降低消耗。
处理措施
按模型原生规格配置上下文窗口(如 gpt-5.5:输入 400,000 / 输出 128,000 / 工具轮次 400)。
接口 · 链路 · 调度 · 配置
根因分析
逐层拆解四个根因,并附后台调用详情、IP 归属查询与用量记录作为证据。点击任意截图可放大查看。
接口层:使用已被淘汰的 Chat Completions 接口
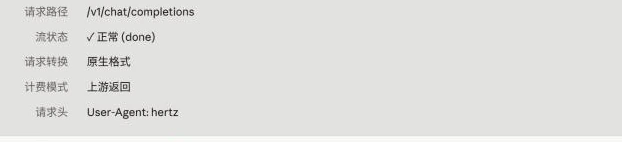
Trae 调用模型走的是 OpenAI 的 Chat Completions 接口(/v1/chat/completions),而非新一代的 Responses 接口。
OpenAI 已在 Codex 中弃用 chat/completions 接口,并于 2026 年 2 月完成移除。
对于新一代推理模型,旧的 Chat 接口需要经过一层「转换层」做适配,会带来能力损失与行为异常 —— 典型表现为部分模型在 Chat 接口下对工具调用、推理控制的支持受限。
链路层:模型调用经字节跳动美国服务器中转
客户的模型调用并非从本地直连 Vibe API,实际链路为:
- 命中 Vibe API 的来源 IP 全部为 IPv6,且分属多个字节网段(如
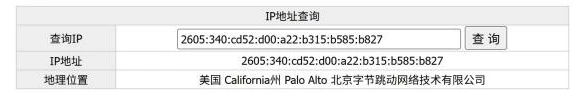
2605:340:cd52:d00:a22:b315:b585:b827、fdbd:dc53:…等) - 经归属查询,
2605:340:cd52:d00:a22:b315:b585:b827归属「美国 California 州 Palo Alto,北京字节跳动网络技术有限公司」 - 测试人员本地出口为 IPv4
175.13.xxx.xxx(电信),且本地不支持 IPv6 - 调用详情中 User-Agent 为
hertz(字节跳动框架),进一步印证请求来自 Trae 后端而非本机
调度层:Trae 不做自动模型调度
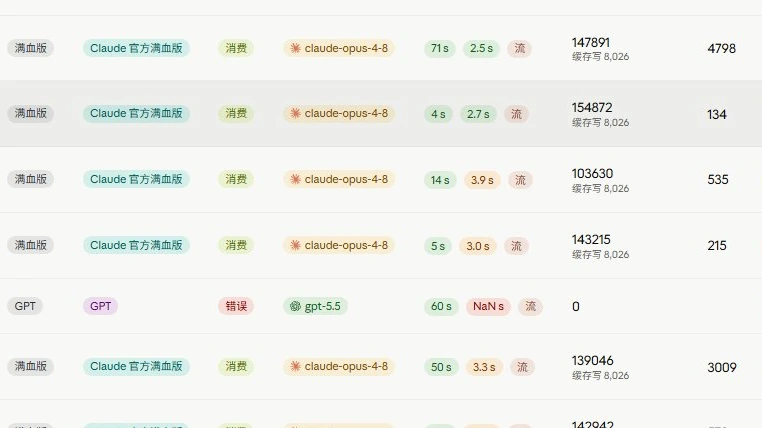
Trae 不具备自动模型调度能力 —— 选定哪个模型,就用哪个模型跑所有任务。 客户首次让其读取大型项目时,全程使用 Opus(claude-opus-4-8)。
正常情况下,项目读取 / 扫描这类轻任务应交由更轻量的模型(如 Haiku)处理,复杂任务再用 Opus,以控制成本。 全程 Opus 直接导致消耗显著偏高。
配置层:上下文窗口被截断
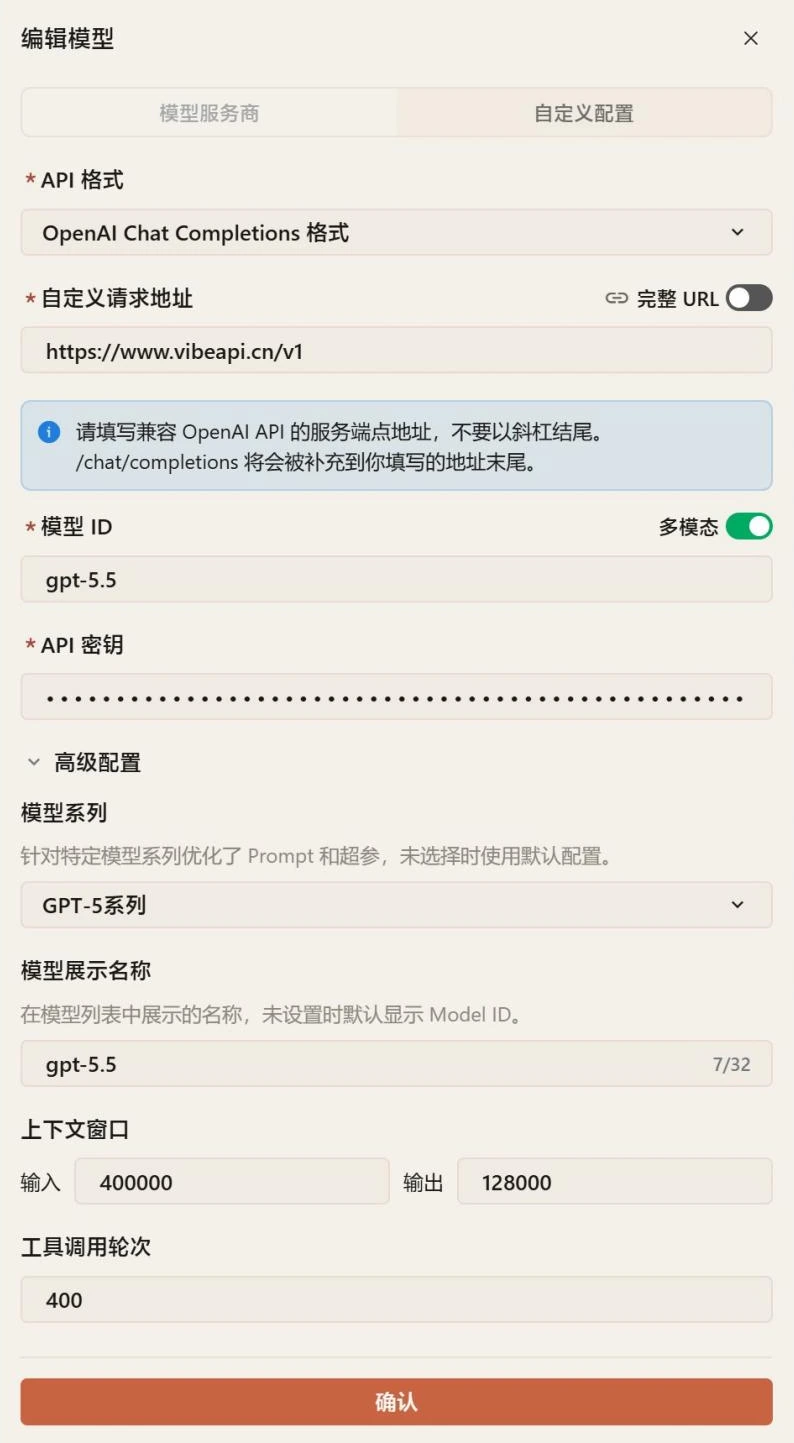
若坚持使用 Trae,需将上下文窗口调整回模型的原生规格,否则会限制模型能力、影响长上下文任务表现。
以 gpt-5.5 为例,应配置为:输入 400,000 tokens;输出 128,000 tokens;工具调用轮次 400。5.4 系列同理。
处理过程
已为客户现场完成环境修复与迁移,并对比迁移前后的消耗。
远程修复本地环境
此前本地环境无法正常配置、相关工具 / 插件安装失败,已远程协助逐项修复。
迁移到 VS Code
将客户开发环境整体迁移至 VS Code,改用官方插件方式运行,绕开 Solo 模式限制。
现场跑通并对比消耗
在迁移后的环境里现场跑通一个任务,并与迁移前的消耗做直接对比。
接口 / 链路 / 调度三层问题一并改善客户理解问题所在
客户现已清楚理解问题根因,认可迁移到官方插件的处理方向。
结论与建议
迁移到官方插件直连后,能力、稳定性与成本可同时改善。五条建议按优先级排列如下。
400k / 输出 128k / 工具轮次 400。
放弃 Trae Solo 模式、改用官方插件直连 —— 接口、链路、调度、配置四层问题一并解决。
迁移后客户侧改善: